Déchiffrer un acte ancien, identifier un nom difficile à lire, extraire les informations essentielles d’un document ou organiser les pistes de recherche : l’intelligence artificielle ouvre aujourd’hui de nouvelles possibilités aux généalogistes. Bien utilisée, elle peut faire gagner du temps, faciliter la lecture de certains documents et aider à structurer une recherche sans pour autant remplacer l’analyse humaine.
Pour ce tutoriel, nous avons choisi ChatGPT comme outil de démonstration afin de suivre une même méthode du début à la fin. Cette démarche n’est toutefois pas limitée à ChatGPT : elle peut être adaptée à d’autres intelligences artificielles disposant de fonctions comparables, comme Gemini, Claude ou Mistral. Les interfaces et les résultats peuvent varier, mais les principes restent les mêmes : formuler une demande précise, conserver les incertitudes, contrôler les réponses obtenues et toujours revenir au document original.
L’enjeu n’est donc pas d’apprendre à utiliser une plateforme particulière, mais de comprendre comment intégrer intelligemment l’IA dans une démarche généalogique rigoureuse. Car une intelligence artificielle peut se tromper, proposer une lecture plausible mais erronée ou compléter une information manquante sans que cela soit immédiatement visible. Elle doit être considérée comme un assistant de recherche, jamais comme une source ou une preuve.
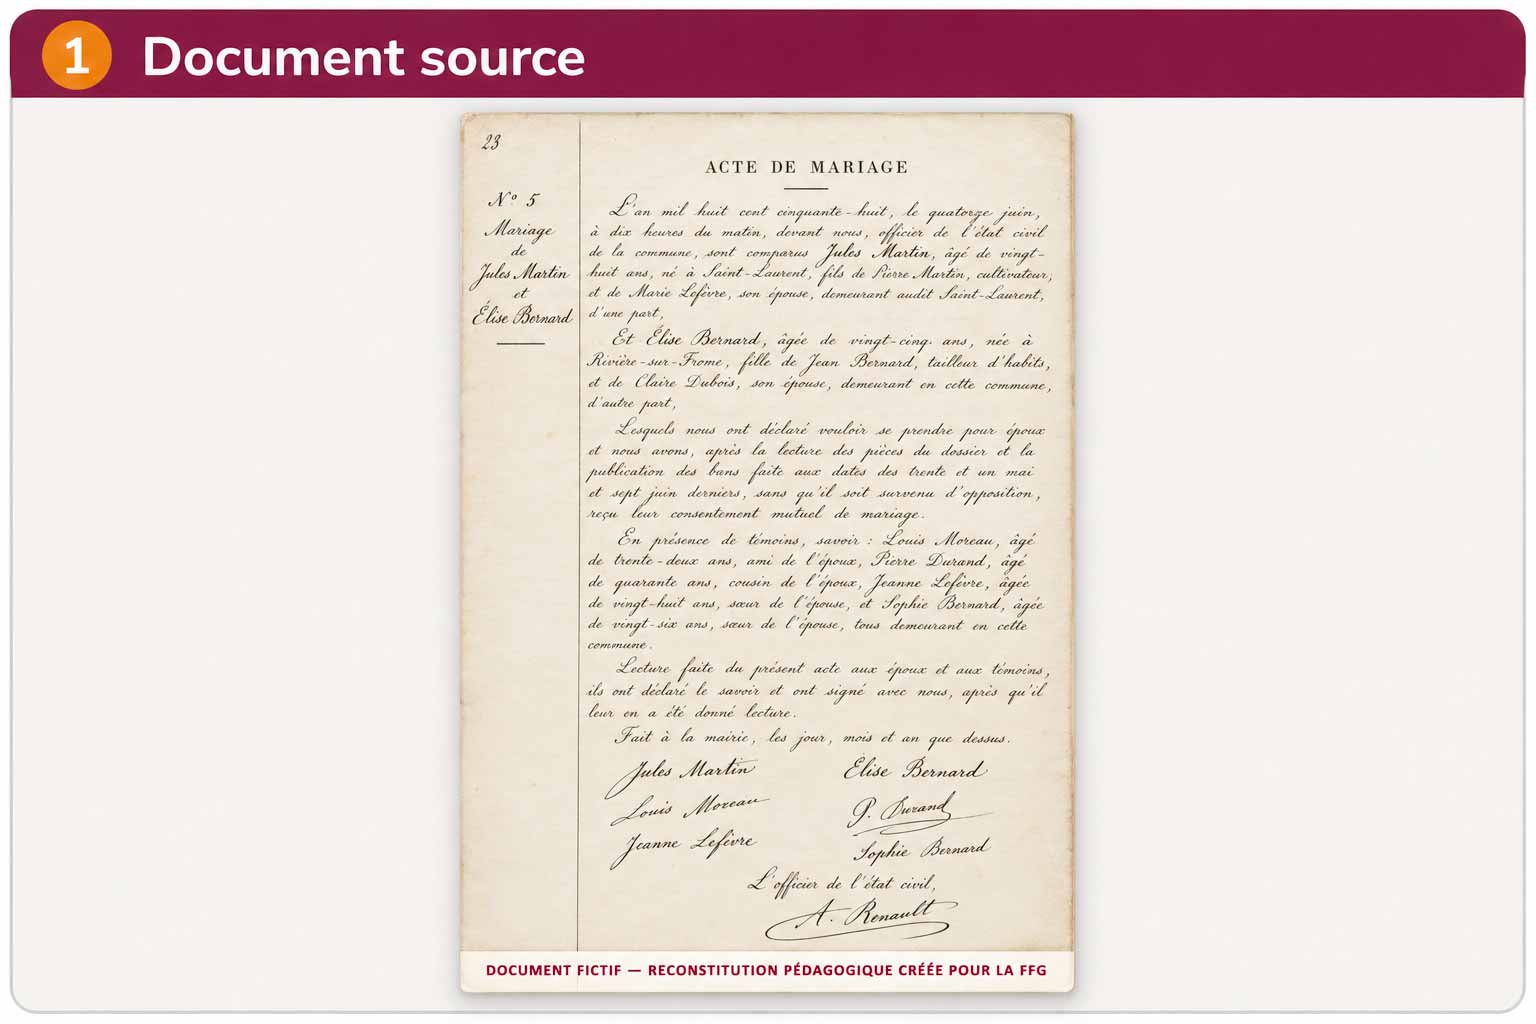
Tout au long de ce tutoriel, nous suivrons un acte de mariage entièrement fictif, daté du 14 juin 1858 et créé exclusivement pour la FFG. À partir de ce document, nous verrons comment préparer une image, demander une transcription prudente, contrôler le résultat, extraire les données généalogiques, construire un plan de recherche et conserver une trace claire des vérifications effectuées.
1. Ce que l’IA peut faire et ce qu’elle ne doit pas décider
L’IA peut interpréter une image ajoutée à une conversation et OpenAI cite notamment l’analyse de documents parmi les usages possibles. Les images acceptées incluent les formats PNG, JPEG et GIF non animé ; la limite annoncée est de 20 Mo par image. Ces indications peuvent évoluer et devront être revérifiées au moment de la publication.
Pour un acte manuscrit, la qualité de l’image reste déterminante. OpenAI avertit qu’une image ambiguë ou peu lisible réduit la précision, que la rotation peut provoquer des erreurs d’interprétation et que les images sont redimensionnées avant analyse. Le lecteur devra donc envoyer une page droite, suffisamment nette et sans recadrage qui supprimerait des éléments utiles.
L’IA ne doit jamais choisir silencieusement entre deux lectures possibles. Elle doit signaler les mots incertains, proposer plusieurs hypothèses si nécessaire et expliquer sur quels indices visibles elle s’appuie. Cette règle constitue le protocole de vérification proposé dans ce tutoriel.
2. Avant le test : document, confidentialité et droit de réutilisation
Avant même d’interroger une intelligence artificielle, quelques précautions s’imposent : tous les documents ne peuvent pas être utilisés de la même manière et leur contenu peut être soumis à des règles de réutilisation ou de protection des données.
Choisir le bon document, vérifier ses conditions d’usage et limiter la transmission d’informations personnelles constituent donc les premières étapes d’une utilisation responsable de l’IA en généalogie. Ces vérifications simples permettent ensuite de travailler dans un cadre plus sûr et plus rigoureux.
2.1 Choisir le bon document
Pour cette démonstration, nous utilisons une reconstitution entièrement fictive d’un acte de mariage daté du 14 juin 1858.
Le document contient des époux, des parents, des témoins, des âges, des professions et plusieurs lieux. Il permet ainsi de montrer les différentes étapes du travail avec l’IA sans utiliser les données personnelles de personnes réelles ni attribuer l’acte à un fonds d’archives existant.
2.2 Vérifier les conditions de reutilisation
L’acte fictif utilisé dans ce tutoriel ne provient d’aucun service d’archives et n’est donc soumis à aucune condition de réutilisation imposée par un tel service.
Les règles présentées ci-dessous concernent le lecteur qui souhaite reproduire cette méthode avec un véritable document d’archives.
La réutilisation d’une image d’archive ne doit pas être supposée identique dans tous les services. FranceArchives présente les différents régimes appliqués par les services d’archives départementales.
Pour les Archives nationales, les informations publiques contenues dans les documents librement communicables sont réutilisables librement et gratuitement, à condition d’indiquer l’origine, la cote, le lieu de conservation et la date des informations.
Des restrictions subsistent notamment pour les documents non librement communicables, les archives privées et les œuvres encore protégées.
2.3 Protéger les données personnelles
La CNIL recommande d’encadrer les usages de l’IA générative, de limiter les données personnelles transmises au service et de vérifier si le prestataire peut les réutiliser. Dans ce tutoriel, aucune donnée personnelle réelle n’est envoyée à l’IA : l’acte et toutes les personnes mentionnées sont fictifs. Avec un véritable document, il faut privilégier un acte ancien librement communicable et vérifier qu’il ne concerne aucune personne vivante.
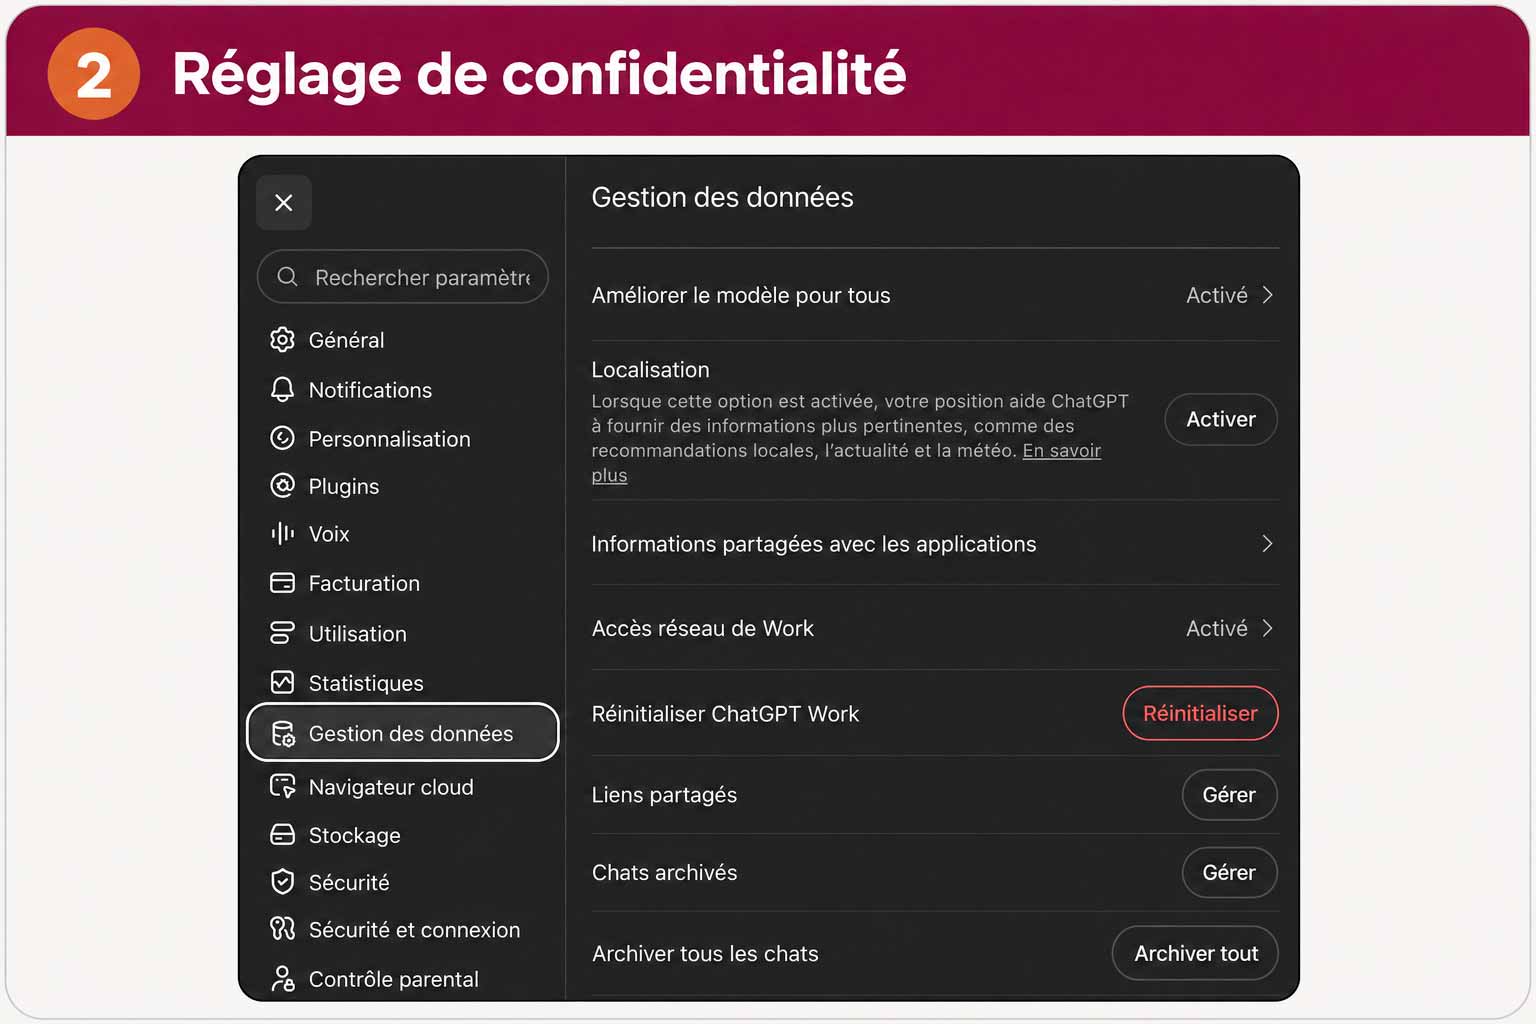
Dans ChatGPT, ouvrez le menu du profil, puis sélectionnez « Paramètres », « Gestion des données » et enfin « Améliorer le modèle pour tous ». Si vous ne souhaitez pas que vos nouvelles conversations servent à l’amélioration des modèles, désactivez cette option. OpenAI précise que les conversations resteront visibles dans l’historique, mais qu’elles ne seront plus utilisées à cette fin.
3. Préparer correctement l’image de l’acte
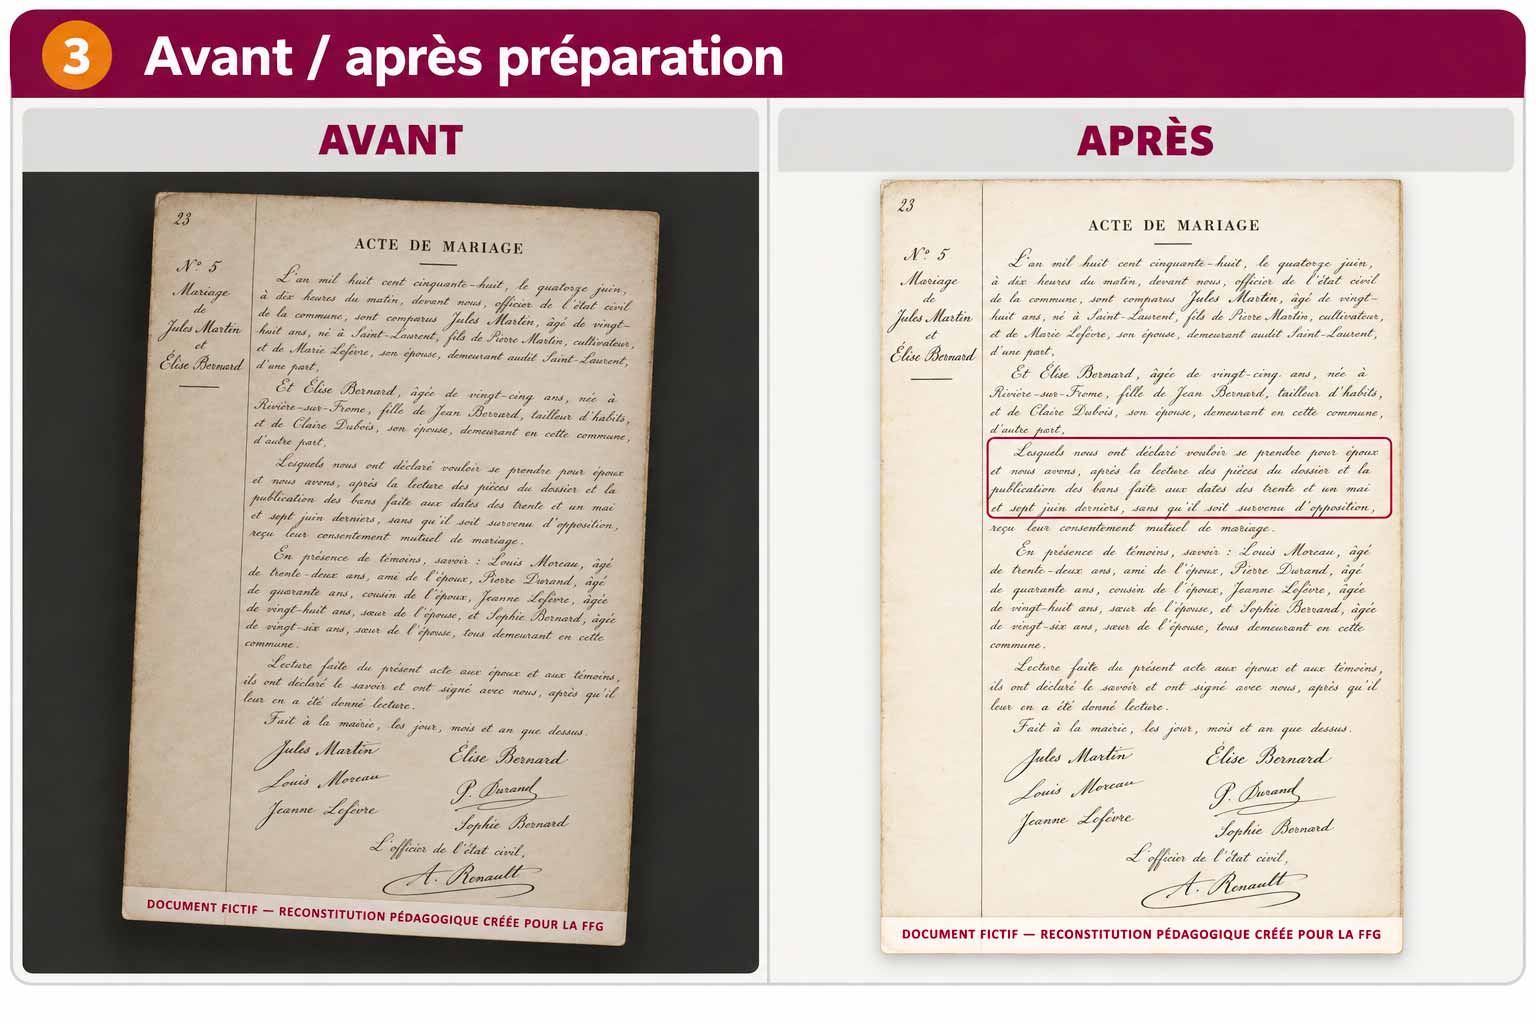
Le lecteur devra conserver une copie intacte du document téléchargé, puis créer une copie de travail. Sur cette copie, il pourra redresser la page, améliorer légèrement la lisibilité et recadrer les marges inutiles, sans supprimer le numéro de page, les mentions marginales ni les éléments permettant de comprendre le contexte.
Cette préparation est un protocole proposé pour le tutoriel. Elle répond aux limites documentées des entrées visuelles : un texte trop petit, une page tournée ou une image peu claire peut diminuer la qualité de l’analyse.
- Conserver l’original sans modification.
- Travailler sur une copie portant un nom explicite.
- Présenter la page dans le bon sens.
- Garder les marges, numéros et mentions utiles.
- Découper séparément une zone difficile si le texte reste trop petit.
Le lecteur devra conserver une copie intacte du document téléchargé, puis créer une copie de travail. Sur cette copie, il pourra redresser la page, améliorer légèrement la lisibilité et recadrer les marges inutiles, sans supprimer le numéro de page, les mentions marginales ni les éléments permettant de comprendre le contexte.
Cette préparation est un protocole proposé pour le tutoriel. Elle répond aux limites documentées des entrées visuelles : un texte trop petit, une page tournée ou une image peu claire peut diminuer la qualité de l’analyse.
- Conserver l’original sans modification.
- Travailler sur une copie portant un nom explicite.
- Présenter la page dans le bon sens.
- Garder les marges, numéros et mentions utiles.
- Découper séparément une zone difficile si le texte reste trop petit.
OpenAI indique que ChatGPT Enterprise peut analyser visuellement les images contenues dans un PDF. Pour les autres offres, les documents sont généralement traités par extraction textuelle et les images intégrées peuvent être écartées. Pour faire analyser l'écriture d'un registre, ajoutez donc directement la page sous la forme d'une image PNG ou JPEG, au lieu de compter sur une image insérée dans un PDF.
4. Obtenir une transcription prudente
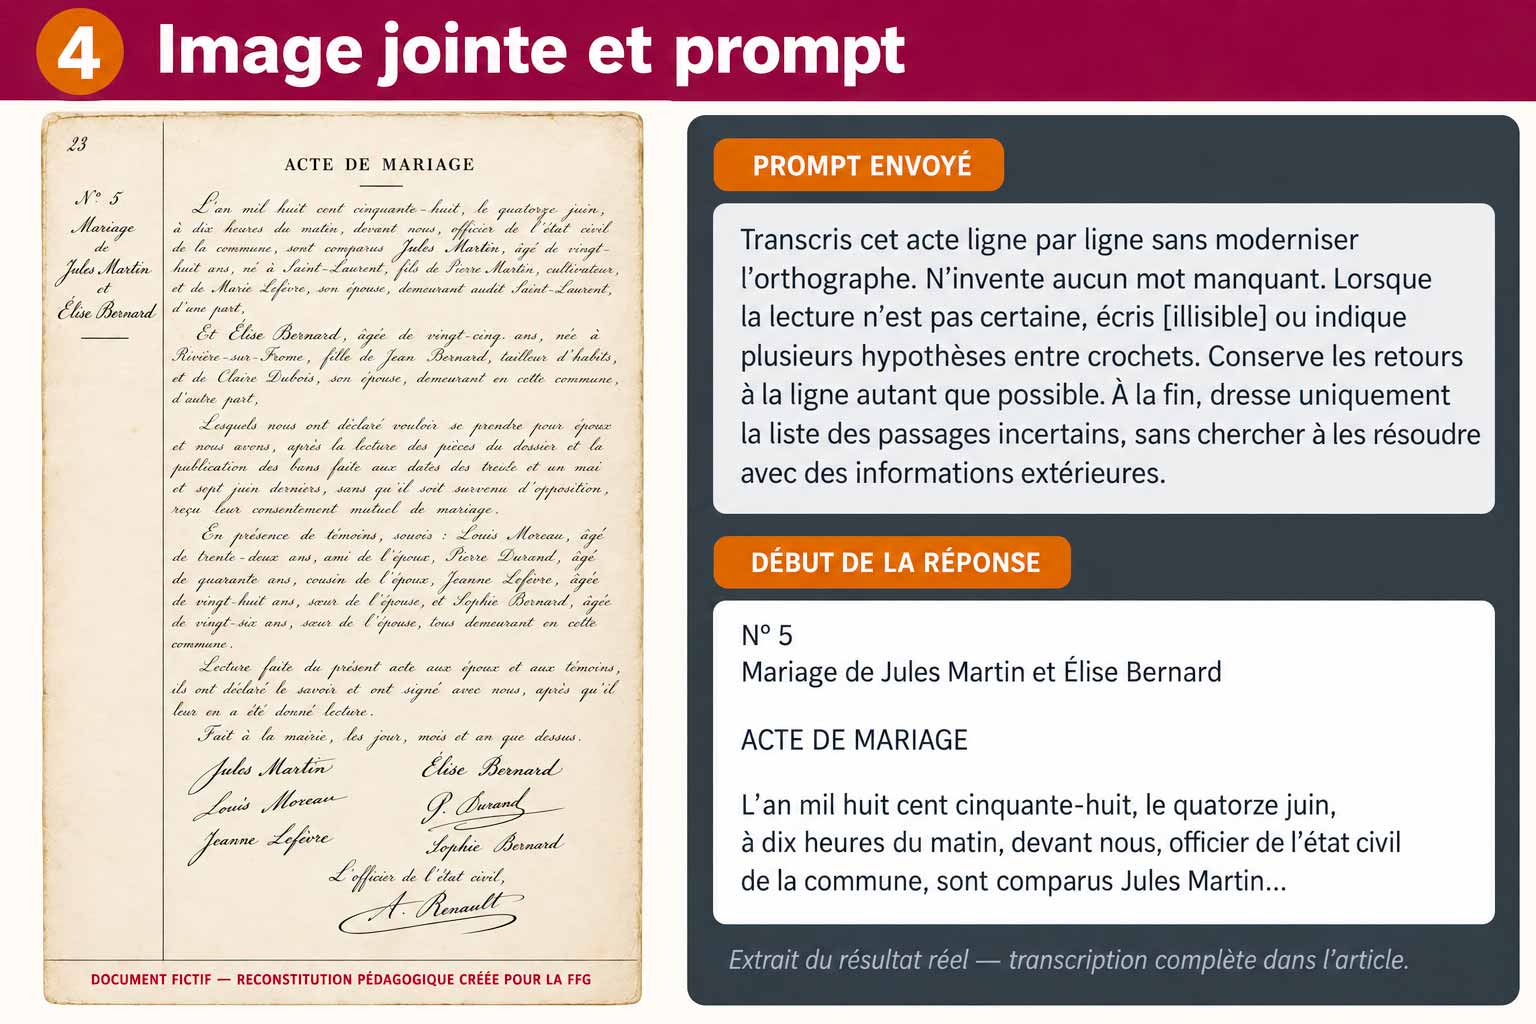
La première demande ne cherchera pas à reconstituer la famille. Elle portera uniquement sur ce qui est visible. Séparer la transcription de l’interprétation réduit le risque de mélanger un mot lu, une hypothèse et une information ajoutée par le modèle.
Transcris cet acte ligne par ligne sans moderniser l'orthographe. N'invente aucun mot manquant. Lorsque la lecture n'est pas certaine, écris [illisible] ou indique plusieurs hypothèses entre crochets. Conserve les retours à la ligne autant que possible. À la fin, dresse uniquement la liste des passages incertains, sans chercher à les résoudre avec des informations extérieures.
5. Contrôler la transcription sur l’original
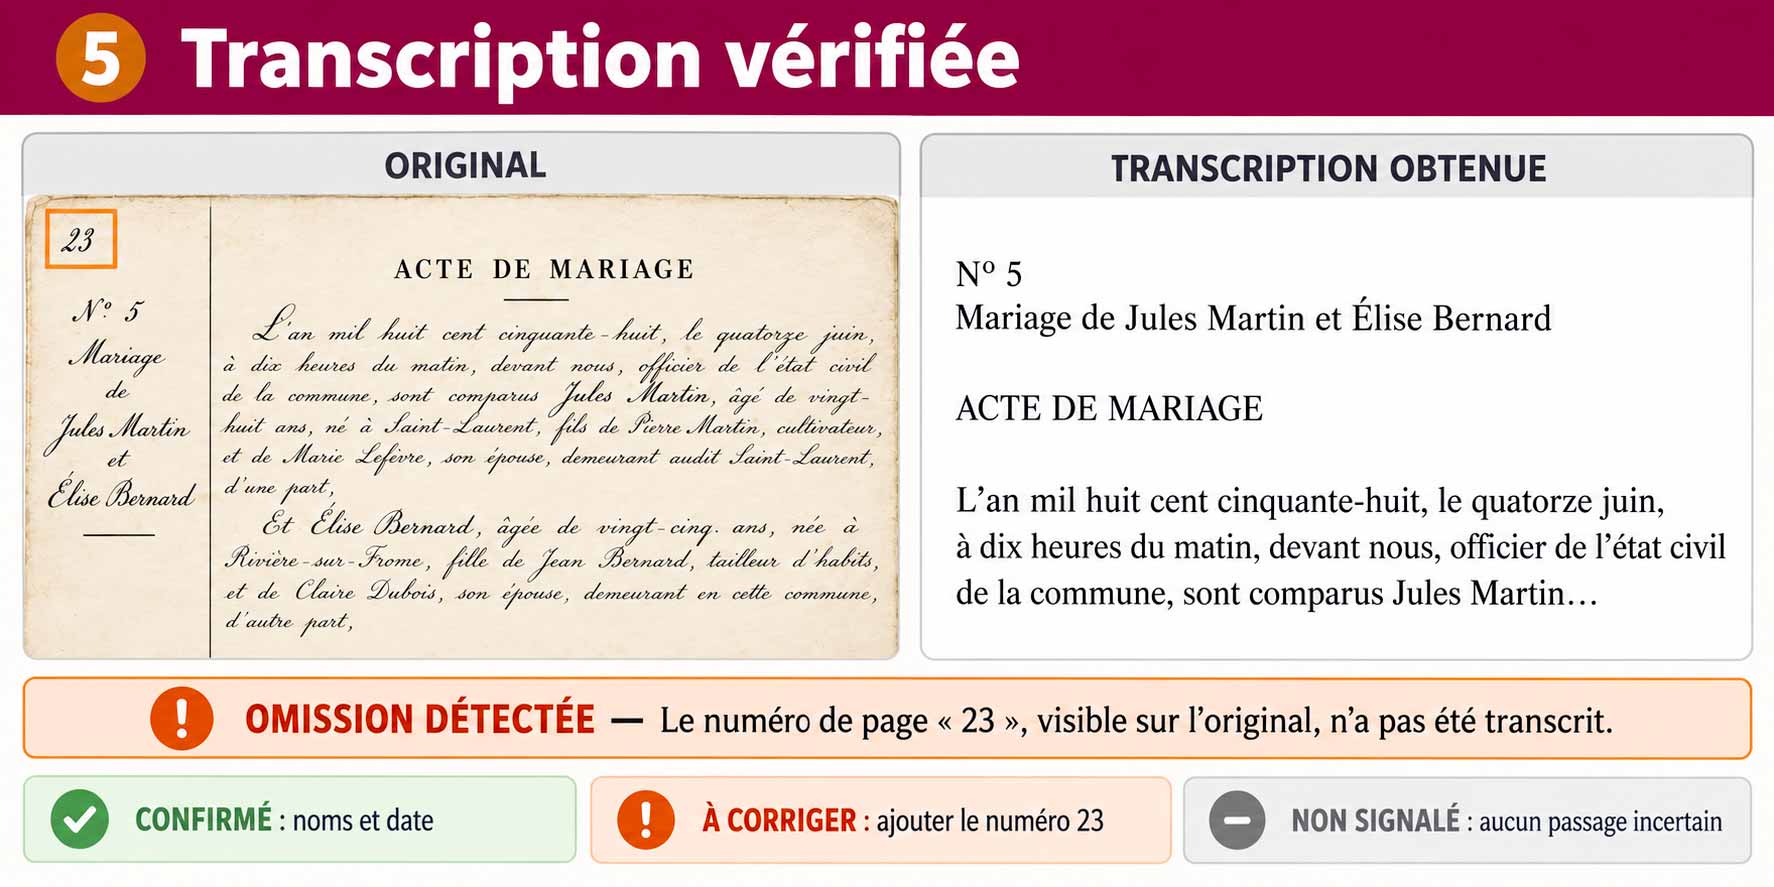
OpenAI précise que ChatGPT peut produire des réponses fausses ou trompeuses, parfois avec assurance, et même fabriquer des références. La transcription obtenue ne doit donc jamais être copiée telle quelle dans un logiciel de généalogie. Elle doit être relue mot à mot sur l’image.
Le contrôle proposé utilise trois marques simples : « confirmé » pour ce qui est clairement visible, « probable » lorsqu’une lecture reste vraisemblable, et « non résolu » lorsque le document ne permet pas de trancher. Ce vocabulaire est une convention éditoriale du tutoriel, non une mesure automatique de fiabilité.
Compare maintenant la transcription avec l'image originale, ligne par ligne. Vérifie également les titres, les numéros de page et d'acte, les mentions marginales et les signatures. Dresse la liste de chaque erreur ou omission constatée. Pour les passages réellement incertains, indique la lecture la plus probable, une autre lecture possible, les lettres visibles et ce qui empêche de conclure. Ne transforme aucune hypothèse en certitude.
6. Extraire les informations généalogiques
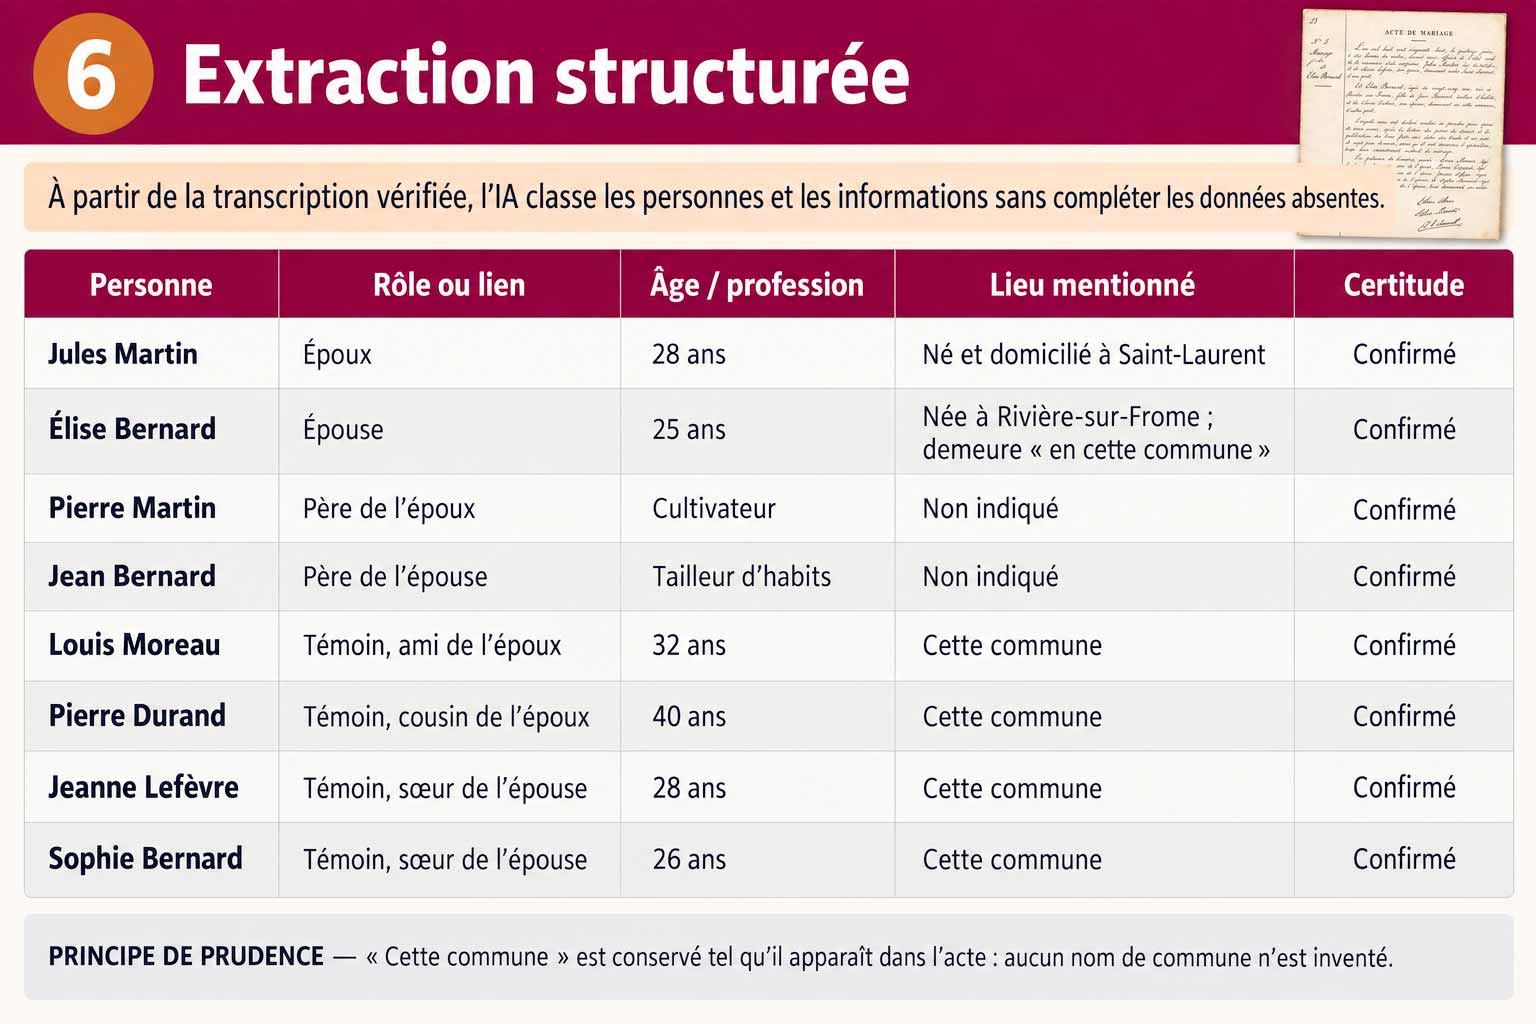
Une fois la transcription contrôlée, l’IA peut aider à transformer le texte en tableau.
’extraction de rubriques précises à partir d’un document fait partie des usages décrits par OpenAI pour les fichiers transmis à ChatGPT.
Cette capacité ne garantit pas l’exactitude des données extraites ; le tableau doit rester relié à la ligne de l’acte qui justifie chaque information.
À partir de la transcription vérifiée ci-dessus, crée un tableau avec les colonnes suivantes : personne, rôle dans l'acte, date, lieu, âge, profession, domicile, lien de parenté, citation exacte de la ligne source, niveau de certitude. N'ajoute aucune information absente du texte. Inscris « non indiqué » lorsqu'une donnée manque.
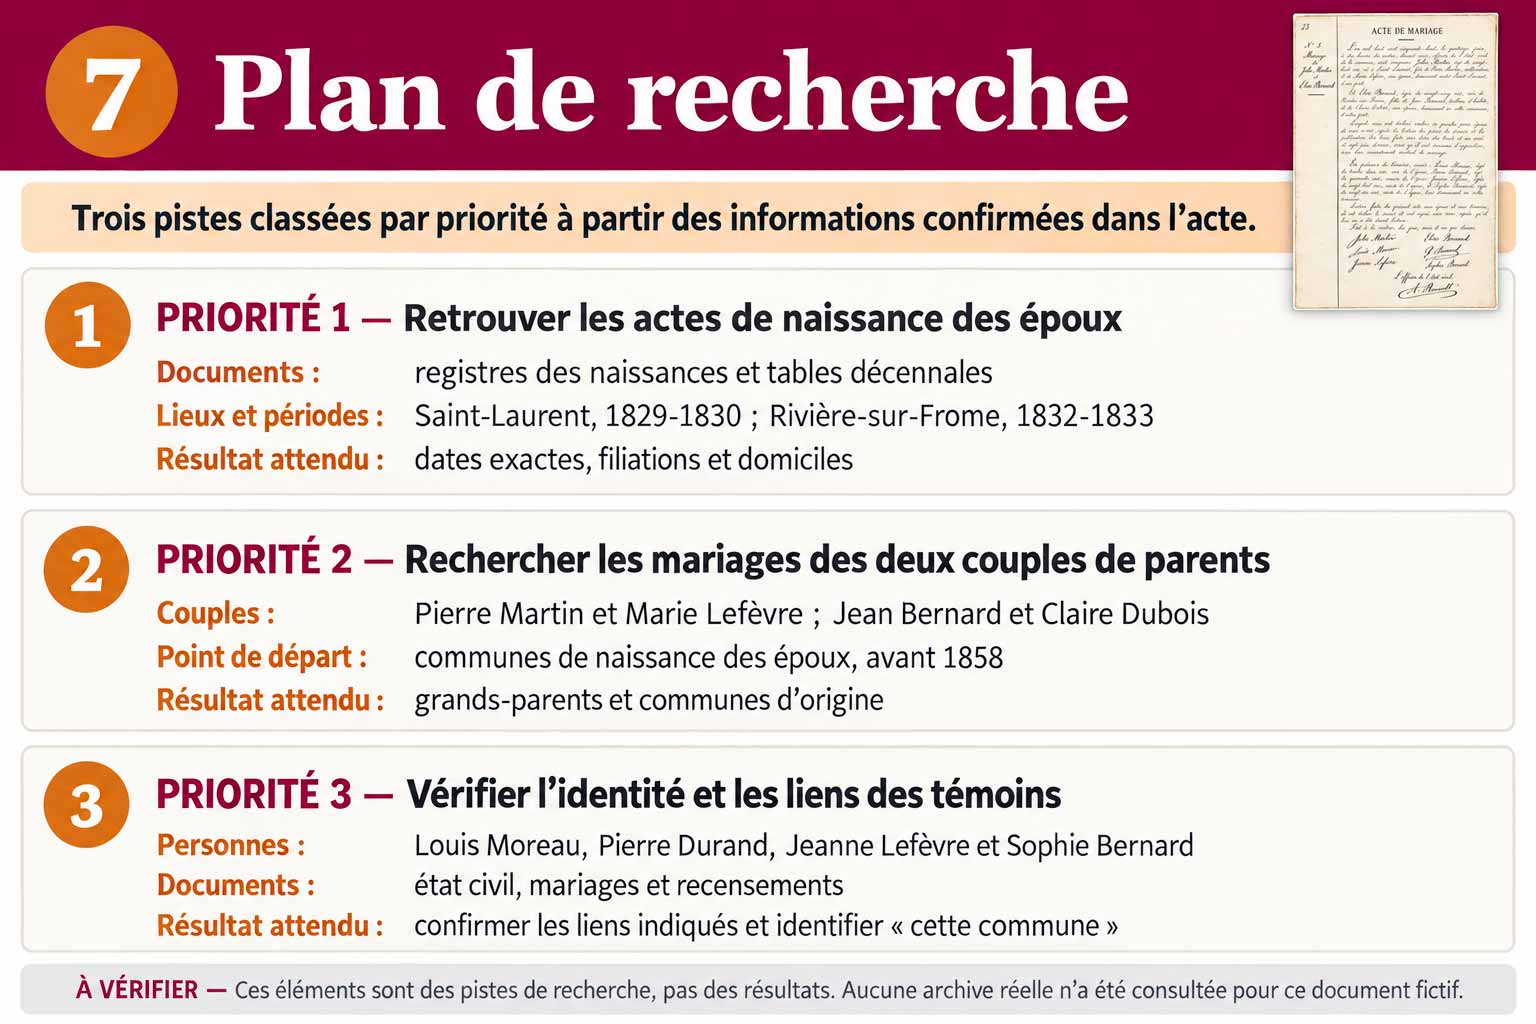
7. Transformer les inconnues en plan de recherche
À ce stade, l’IA ne doit pas annoncer qu’elle a « retrouvé » un ancêtre.
Elle peut en revanche aider à dresser une liste d’hypothèses et de fonds à consulter.
Toute recherche sur le Web devra utiliser l’outil de recherche disponible et fournir des liens que le lecteur pourra ouvrir ; sans recherche, la réponse dépend des connaissances apprises par le modèle et peut être dépassée.
À partir des informations confirmées dans le tableau, propose un plan de recherche classé par priorité. Pour chaque piste, indique : l'objectif, le type de document à rechercher, la période, le lieu, les variantes orthographiques à tester et le résultat attendu. Sépare clairement les faits établis des hypothèses. Ne prétends pas avoir consulté une archive ou une base si tu ne l'as pas réellement ouverte.
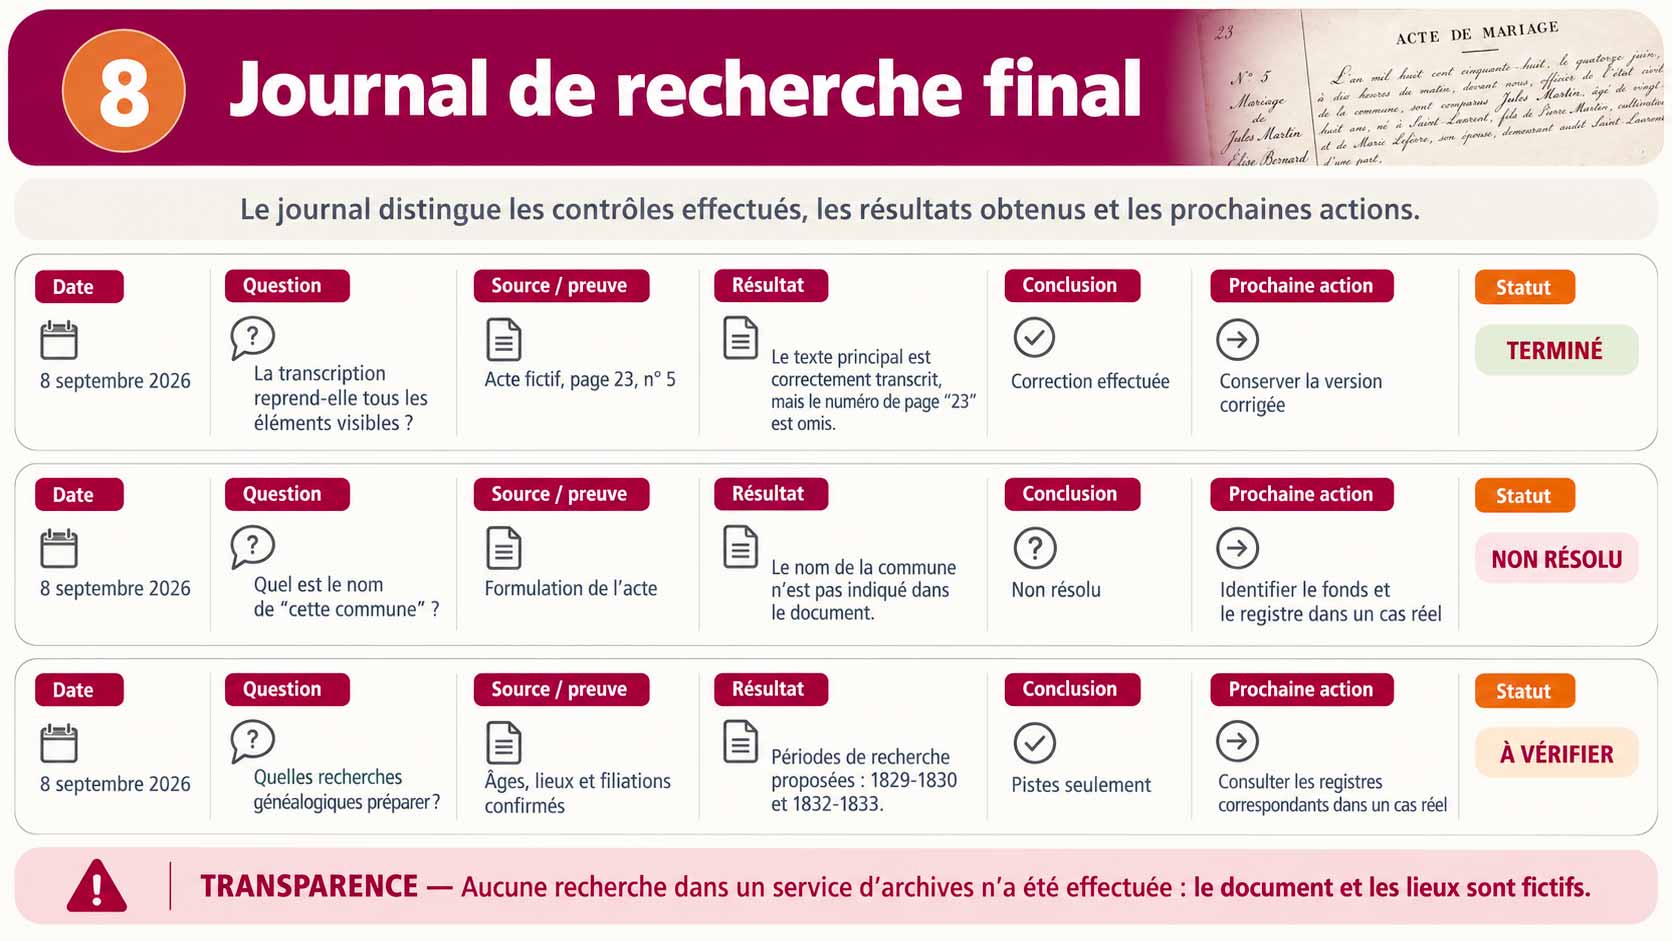
8. Tenir un journal de recherche
Le journal final séparera les recherches effectuées, leurs résultats et les prochaines actions. Cette structure est proposée pour préserver la traçabilité du travail et empêcher qu’une piste non vérifiée soit réutilisée plus tard comme un fait.
Crée un journal de recherche avec les colonnes : date, question recherchée, source consultée, cote ou URL, personne concernée, résultat, preuve conservée, conclusion, prochaine action. N'inscris aucune source que je ne t'ai pas fournie ou que tu n'as pas réellement consultée avec un outil de recherche.
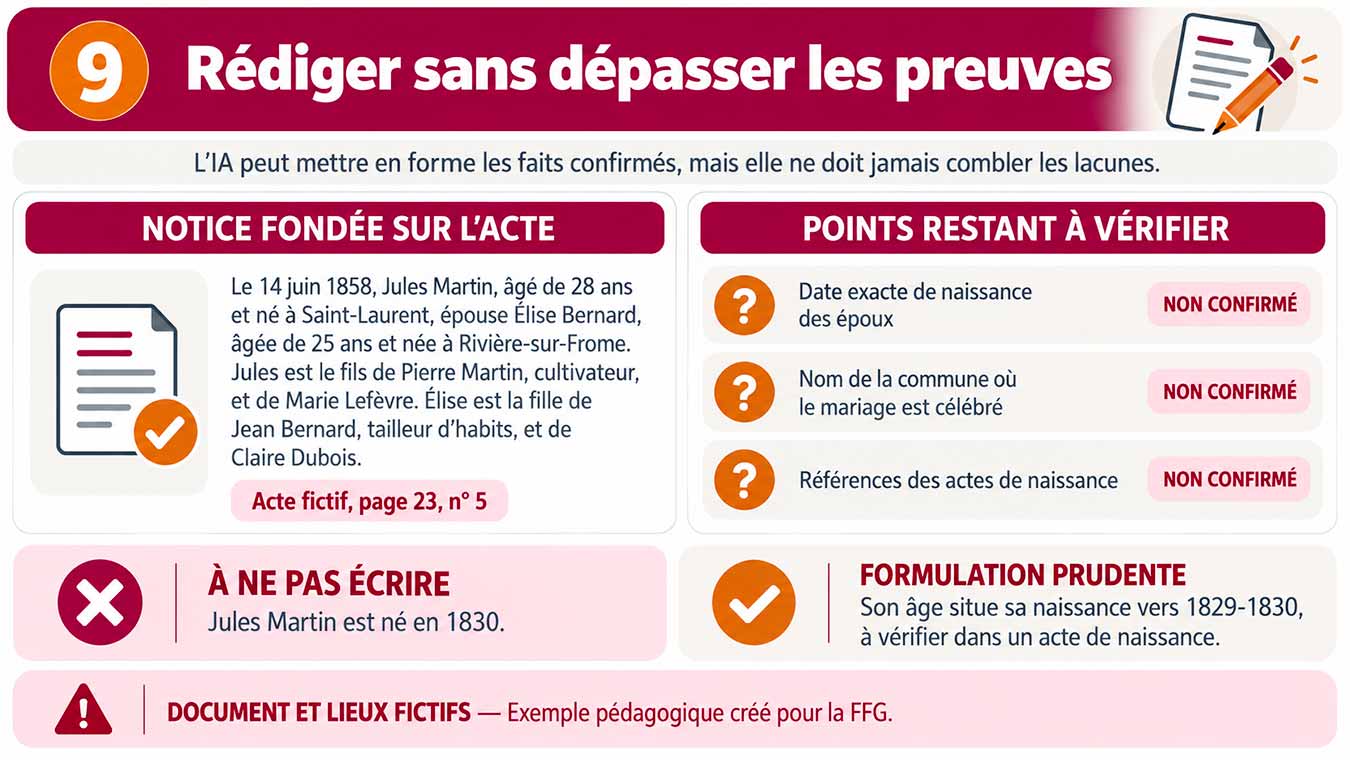
9. Rédiger sans dépasser les preuves
L’IA peut enfin aider à transformer les données confirmées en récit lisible.
Le texte devra conserver les nuances : une profession difficile à lire, une commune supposée ou une filiation non démontrée ne doivent pas être reformulées comme des certitudes.
Rédige une courte notice biographique uniquement à partir des lignes marquées « confirmé ». Ajoute ensuite un paragraphe distinct intitulé « Points restant à vérifier ». Ne complète aucune lacune par vraisemblance et conserve les références des documents entre parenthèses.
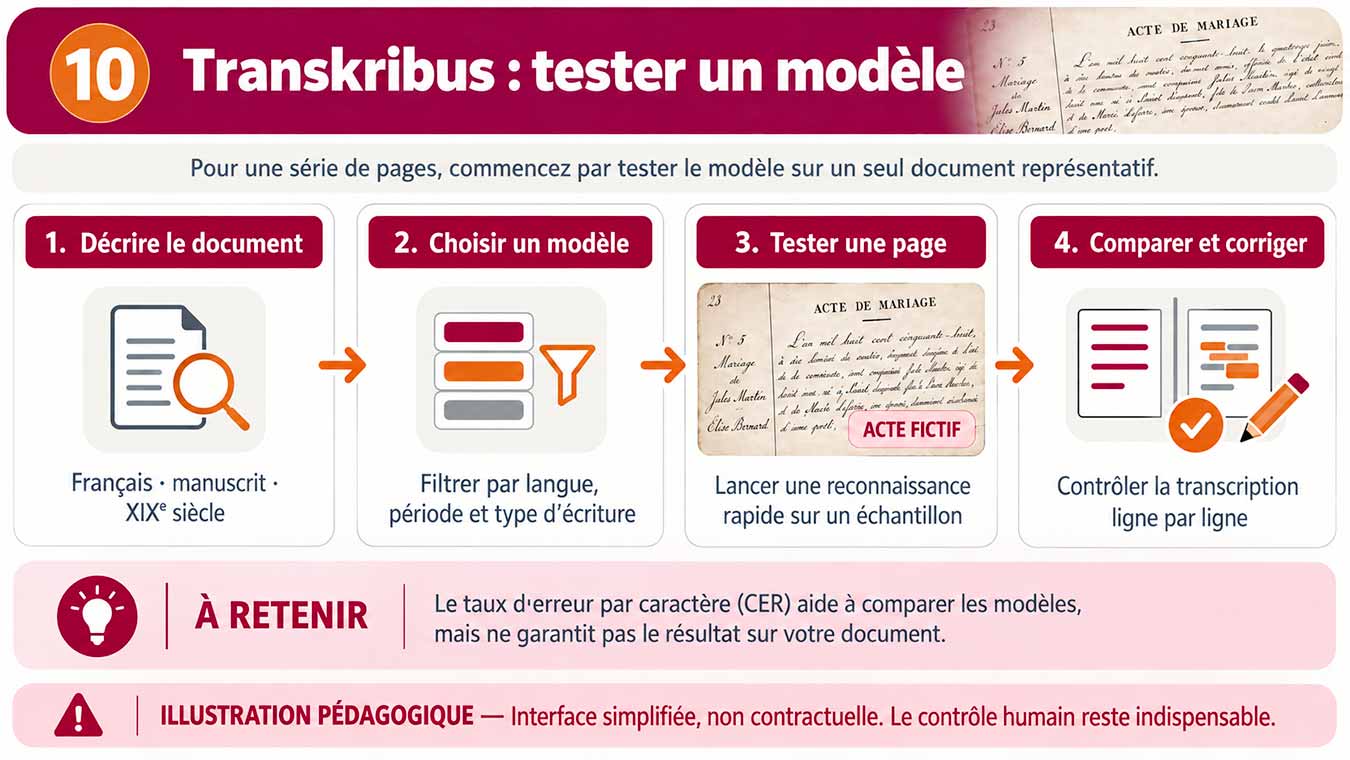
10. Pour des séries de pages : distinguer ChatGPT et un outil spécialisé
Le tutoriel principal utilisera ChatGPT pour une page ou un petit dossier, car l’objectif est d’apprendre à dialoguer avec l’IA et à contrôler le résultat.
Pour des registres ou des ensembles plus volumineux, un encadré présentera Transkribus comme outil spécialisé dans la reconnaissance des textes manuscrits et imprimés historiques.
Transkribus propose des modèles de reconnaissance adaptés à différents types de documents.
Son propre guide recommande d’identifier la langue, la période, le type d’écriture et la nature manuscrite ou imprimée, puis de tester un modèle sur un échantillon avant de lancer un traitement plus large.
Le taux d’erreur par caractère annoncé pour un modèle constitue un indicateur, pas une garantie sur un document particulier.
11. Les règles à retenir
- Toujours conserver le document original et sa référence complète.
- Transcrire avant d’interpréter.
- Forcer l’IA à signaler ce qu’elle ne lit pas.
- Comparer chaque nom, date et lieu avec l’image.
- Ne pas transmettre inutilement de données relatives à des personnes vivantes.
- Vérifier les conditions de réutilisation du service d’archives concerné.
- Ne jamais accepter une référence que l’on ne peut pas ouvrir et contrôler.
- Séparer les faits, les hypothèses et les pistes de recherche.
- Conserver les recherches infructueuses dans le journal.
- Présenter le résultat de l’IA comme une aide de travail, jamais comme une preuve autonome.